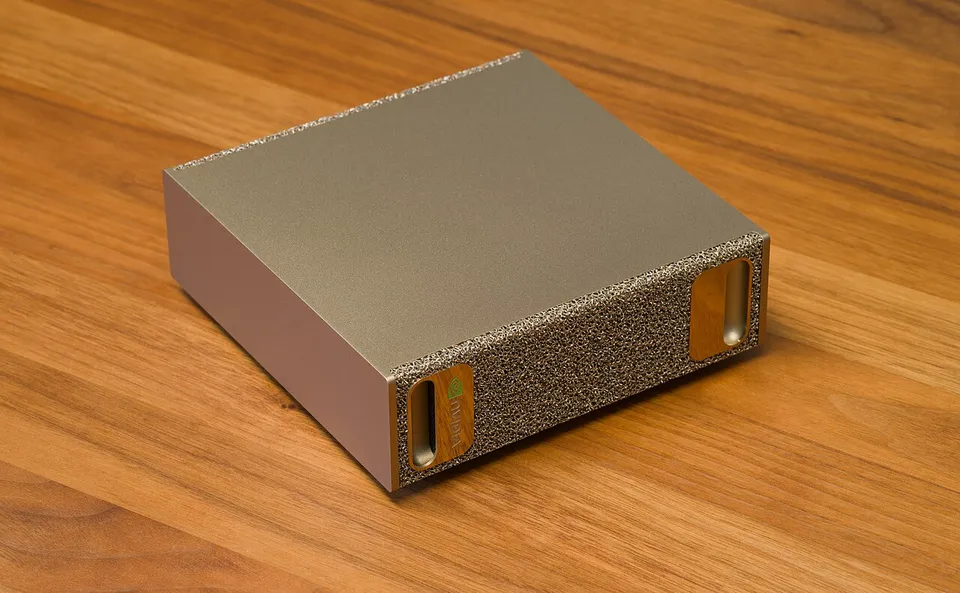

NVIDIA DGX Spark tiene 128 GB de memoria unificada (LPDDR5X), con un ancho de banda de 273 GB/s según el fabricante. Con nuestros supuestos, puede alojar modelos de hasta unos 130 mil millones de parámetros a 4 bits, 72 mil millones a 8 bits y 38 mil millones a 16 bits. El mayor modelo de nuestra lista de referencia que cabe con margen a 4 bits es Mistral-Medium-3.5-128B (128 B); a 16 bits, Qwen3.6-35B-A3B (35 B). Por memoria utilizable, ocupa el puesto 8 de 11 en sistemas nvidia gb10 (familia dgx spark) de nuestro catálogo.
Precio y dónde comprar
- 7.490 €en NVIDIA Marketplace España el 17/11/2026.Variante: DGX Spark Founders Edition, 128 GB + 4 TB.Disponibilidad en esa fecha: Disponible (botón «Añadir al carrito» activo).
Precio que mostraba la tienda en la fecha indicada; puede haber cambiado. No es un enlace de afiliado. Compara siempre la misma memoria y el mismo almacenamiento, y comprueba envío e impuestos en la tienda.
Cómo se reparte la memoria
Memoria unificada o compartida: 75 % del total, salvo que el fabricante documente cuánta puede asignarse a la GPU; el sistema operativo y las aplicaciones necesitan el resto. Del espacio utilizable reservamos un 20 % para contexto (caché KV), activaciones y el motor: un usuario con contexto moderado. Contextos largos o varias personas a la vez necesitan más.
Qué modelos caben
Modelos abiertos de referencia, con los parámetros de su ficha oficial. En los modelos MoE caben todos los parámetros aunque solo se activen algunos por palabra generada. Si un modelo se publica ya en 4 bits o menos (lo indicamos junto al nombre), esa es su columna de referencia.
| Modelo | Parámetros | 4 bits | 8 bits | 16 bits |
|---|---|---|---|---|
| FLUX.2 [klein] 4BBlack Forest Labs · pesos oficiales en BF16 | 4 B | Cabe con margen | Cabe con margen | Cabe con margen |
| FLUX.3 Image [klein]Black Forest Labs · pesos oficiales en BF16 | 5,6 B | Cabe con margen | Cabe con margen | Cabe con margen |
| FLUX.2 [klein] 9BBlack Forest Labs · pesos oficiales en BF16 | 9 B | Cabe con margen | Cabe con margen | Cabe con margen |
| FLUX.1 [dev]Black Forest Labs · pesos oficiales en BF16 | 12 B | Cabe con margen | Cabe con margen | Cabe con margen |
| FLUX.2 [dev]Black Forest Labs · pesos oficiales en BF16 | 32 B | Cabe con margen | Cabe con margen | Cabe con margen |
| DeepSeek-V4-FlashDeepSeek · pesos oficiales en FP4+FP8 | 284 B13 B activos | No cabe | No cabe | No cabe |
| DeepSeek-V4.1-FlashDeepSeek · pesos oficiales en FP8 | 552 B16 B activos | No cabe | No cabe | No cabe |
| DeepSeek-V3.2DeepSeek · pesos oficiales en FP8 | 685 B | No cabe | No cabe | No cabe |
| DeepSeek-R1-0528DeepSeek · pesos oficiales en FP8 | 685 B | No cabe | No cabe | No cabe |
| DeepSeek-V4-ProDeepSeek · pesos oficiales en FP4+FP8 | 1600 B49 B activos | No cabe | No cabe | No cabe |
| Gemma 4 E2BGoogle · pesos oficiales en BF16 | 5,1 B2,3 B activos | Cabe con margen | Cabe con margen | Cabe con margen |
| Gemma 4 E4BGoogle · pesos oficiales en BF16 | 8 B4,5 B activos | Cabe con margen | Cabe con margen | Cabe con margen |
| Gemma 4 12BGoogle · pesos oficiales en BF16 | 12 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Gemma 4 26B A4BGoogle · pesos oficiales en BF16 | 25,2 B3,8 B activos | Cabe con margen | Cabe con margen | Cabe con margen |
| Gemma 4 31BGoogle · pesos oficiales en BF16 | 30,7 B | Cabe con margen | Cabe con margen | Cabe con margen |
| granite-4.2-3bIBM · pesos oficiales en BF16 | 3 B | Cabe con margen | Cabe con margen | Cabe con margen |
| granite-4.2-8bIBM · pesos oficiales en BF16 | 8 B | Cabe con margen | Cabe con margen | Cabe con margen |
| granite-4.2-30bIBM · pesos oficiales en BF16 | 30 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Llama-3.1-8B-InstructMeta | 8 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Llama-3.3-70B-InstructMeta | 70 B | Cabe con margen | Cabe con margen | No cabe |
| Llama-4-Scout-17B-16E-InstructMeta · pesos oficiales en BF16 | 109 B17 B activos | Cabe con margen | No cabe | No cabe |
| Llama-4-Maverick-17B-128E-InstructMeta · pesos oficiales en BF16 y FP8 | 400 B17 B activos | No cabe | No cabe | No cabe |
| Llama-3.1-405B-InstructMeta · pesos oficiales en BF16 | 405 B | No cabe | No cabe | No cabe |
| Phi-4-mini-instructMicrosoft · pesos oficiales en BF16 | 3,8 B | Cabe con margen | Cabe con margen | Cabe con margen |
| phi-4Microsoft · pesos oficiales en BF16 | 14 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Phi-4-reasoning-vision-15BMicrosoft · pesos oficiales en BF16 | 15 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Ministral-3-14B-Instruct-2512Mistral AI · pesos oficiales en FP8 | 14 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Devstral-Small-2-24B-Instruct-2512Mistral AI · pesos oficiales en FP8 | 24 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Magistral-Small-2509Mistral AI · pesos oficiales en BF16 | 24 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Mistral-Small-4-119B-2603Mistral AI · pesos oficiales en BF16 y FP8 | 119 B6,5 B activos | Cabe con margen | No cabe | No cabe |
| Devstral-2-123B-Instruct-2512Mistral AI · pesos oficiales en FP8 | 123 B | Cabe con margen | No cabe | No cabe |
| Mistral-Medium-3.5-128BMistral AI · pesos oficiales en BF16 y FP8 | 128 B | Cabe con margen | No cabe | No cabe |
| Mistral-Large-3-675B-Instruct-2512Mistral AI · pesos oficiales en FP8 | 675 B41 B activos | No cabe | No cabe | No cabe |
| Mistral-Large-4-1T-A52BMistral AI · pesos oficiales en FP8 | 1000 B52 B activos | No cabe | No cabe | No cabe |
| Kimi-K2.6Moonshot AI · pesos oficiales en INT4 nativo | 1000 B32 B activos | No cabe | No cabe | No cabe |
| Kimi-K2-Instruct-0905Moonshot AI · pesos oficiales en FP8 (block) | 1000 B32 B activos | No cabe | No cabe | No cabe |
| Kimi-K3Moonshot AI · pesos oficiales en MXFP4 (QAT) | 2800 B104 B activos | No cabe | No cabe | No cabe |
| Kimi-K3.1-ProMoonshot AI · pesos oficiales en MXFP4 (QAT) | 2800 B104 B activos | No cabe | No cabe | No cabe |
| parakeet-tdt-0.6b-v3NVIDIA · pesos oficiales en F32 | 0,6 B | Cabe con margen | Cabe con margen | Cabe con margen |
| canary-1b-v2NVIDIA · pesos oficiales en F32 | 1 B | Cabe con margen | Cabe con margen | Cabe con margen |
| NVIDIA-Nemotron-3-Nano-4BNVIDIA · pesos oficiales en BF16 | 4 B | Cabe con margen | Cabe con margen | Cabe con margen |
| NVIDIA-Nemotron-3.5-Bolt-E4BNVIDIA · pesos oficiales en BF16 | 8 B4 B activos | Cabe con margen | Cabe con margen | Cabe con margen |
| Cosmos-Reason2-8BNVIDIA · pesos oficiales en BF16 | 8,8 B | Cabe con margen | Cabe con margen | Cabe con margen |
| NVIDIA-Nemotron-Nano-9B-v2NVIDIA · pesos oficiales en BF16 | 9 B | Cabe con margen | Cabe con margen | Cabe con margen |
| NVIDIA-Nemotron-Nano-12B-v2-VLNVIDIA · pesos oficiales en BF16 | 12,6 B | Cabe con margen | Cabe con margen | Cabe con margen |
| NVIDIA-Nemotron-3-Nano-30B-A3BNVIDIA · pesos oficiales en BF16 | 30 B3,5 B activos | Cabe con margen | Cabe con margen | Cabe con margen |
| NVIDIA-Nemotron-3.5-Lightning-30B-A3BNVIDIA · pesos oficiales en BF16 | 30 B3 B activos | Cabe con margen | Cabe con margen | Cabe con margen |
| Nemotron-3-Nano-Omni-30B-A3B-ReasoningNVIDIA · pesos oficiales en BF16 | 31 B3 B activos | Cabe con margen | Cabe con margen | Cabe con margen |
| OpenReasoning-Nemotron-32BNVIDIA · pesos oficiales en BF16 | 32 B | Cabe con margen | Cabe con margen | Cabe con margen |
| NVIDIA-Nemotron-3.5-Transcribe-30B-A4BNVIDIA · pesos oficiales en BF16 | 34 B4,3 B activos | Cabe con margen | Cabe con margen | Cabe con margen |
| Llama-3.3-Nemotron-Super-49B-v1.5NVIDIA · pesos oficiales en BF16 | 50 B | Cabe con margen | Cabe con margen | No cabe |
| Cosmos3-SuperNVIDIA · pesos oficiales en BF16 | 64 B | Cabe con margen | Cabe con margen | No cabe |
| NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GBNVIDIA · pesos oficiales en IQ2 (2 bits, QAT) | 74 B9 B activos | Cabe con margen | Justo: caben los pesos, poco contexto | No cabe |
| NVIDIA-Nemotron-3-Super-120B-A12BNVIDIA · pesos oficiales en BF16 | 120 B12 B activos | Cabe con margen | No cabe | No cabe |
| NVIDIA-Nemotron-3.5-Super-VL-120B-A12BNVIDIA · pesos oficiales en BF16 | 120 B12 B activos | Cabe con margen | No cabe | No cabe |
| Llama-3.1-Nemotron-Ultra-253B-v1NVIDIA · pesos oficiales en BF16 | 253 B | No cabe | No cabe | No cabe |
| NVIDIA-Nemotron-3-Ultra-550B-A55BNVIDIA · pesos oficiales en BF16 | 550 B55 B activos | No cabe | No cabe | No cabe |
| whisper-large-v3-turboOpenAI · pesos oficiales en F16 | 0,8 B | Cabe con margen | Cabe con margen | Cabe con margen |
| whisper-large-v3OpenAI · pesos oficiales en F16 | 1,6 B | Cabe con margen | Cabe con margen | Cabe con margen |
| gpt-oss-20bOpenAI · pesos oficiales en MXFP4 | 21 B3,6 B activos | Cabe con margen | Cabe con margen | Cabe con margen |
| gpt-oss-120bOpenAI · pesos oficiales en MXFP4 | 117 B5,1 B activos | Cabe con margen | No cabe | No cabe |
| Qwen3.5-4BQwen (Alibaba) · pesos oficiales en BF16 | 4 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Qwen-Image-2.1Qwen (Alibaba) · pesos oficiales en BF16 | 7 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Qwen3.5-9BQwen (Alibaba) · pesos oficiales en BF16 | 9 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Qwen3.8-27BQwen (Alibaba) · pesos oficiales en BF16 | 27 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Qwen3.6-35B-A3BQwen (Alibaba) · pesos oficiales en BF16 | 35 B3 B activos | Cabe con margen | Cabe con margen | Cabe con margen |
| Qwen3-Coder-NextQwen (Alibaba) · pesos oficiales en BF16 | 80 B3 B activos | Cabe con margen | Justo: caben los pesos, poco contexto | No cabe |
| Qwen3.5-122B-A10BQwen (Alibaba) · pesos oficiales en BF16 | 122 B10 B activos | Cabe con margen | No cabe | No cabe |
| Qwen3.8-Flash-NextQwen (Alibaba) · pesos oficiales en BF16 | 125 B6 B activos | Cabe con margen | No cabe | No cabe |
| Qwen3.5-397B-A17BQwen (Alibaba) · pesos oficiales en BF16 | 397 B17 B activos | No cabe | No cabe | No cabe |
| Qwen3.8-2.4T-A95BQwen (Alibaba) · pesos oficiales en BF16 | 2400 B95 B activos | No cabe | No cabe | No cabe |
| Stable Diffusion 3.5 MediumStability AI · pesos oficiales en BF16 | 2 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Stable Diffusion 3.5 LargeStability AI · pesos oficiales en BF16 | 8 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Wan2.2-TI2V-5BWan-AI (Alibaba) | 5 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Wan2.2-T2V-A14BWan-AI (Alibaba) | 27 B14 B activos | Cabe con margen | Cabe con margen | Cabe con margen |
| GLM-4.7-FlashZhipu AI (Z.ai) · pesos oficiales en BF16 | 30 B3 B activos | Cabe con margen | Cabe con margen | Cabe con margen |
| GLM-4.5-AirZhipu AI (Z.ai) · pesos oficiales en BF16 | 106 B12 B activos | Cabe con margen | No cabe | No cabe |
| GLM-5.3-FlashZhipu AI (Z.ai) · pesos oficiales en FP8 y BF16 | 320 B18 B activos | No cabe | No cabe | No cabe |
| GLM-5.3Zhipu AI (Z.ai) · pesos oficiales en FP8 y BF16 | 753 B | No cabe | No cabe | No cabe |
- Encaje que merece estudiar
- Equipo técnico que valida desarrollo e inferencia en plataforma NVIDIA compacta
- Cuándo no lo elegiríamos
- Sustituto automático de servidor x86 o promesa de servicio multiusuario sin dimensionar
Equipos con memoria parecida
Otros equipos del catálogo con una memoria utilizable similar (±35 %), de cualquier tipo. Útil para comparar formatos: tarjeta, mini PC, Mac o sistema NVIDIA.
- MSI EdgeXpert MS-C931 128 GB · memoria unificada o compartida · ≈ 130 B a 4 bits
- Lenovo ThinkStation PGX 128 GB · memoria unificada o compartida · ≈ 130 B a 4 bits
- HP ZGX Nano G1n 128 GB · memoria unificada o compartida · ≈ 130 B a 4 bits
- GIGABYTE AI TOP ATOM 128 GB · memoria unificada o compartida · ≈ 130 B a 4 bits
- Dell Pro Max GB10 128 GB · memoria unificada o compartida · ≈ 130 B a 4 bits
- ASUS Ascent GX10 128 GB · memoria unificada o compartida · ≈ 130 B a 4 bits
Ficha técnica
| Memoria | 128 GB · Memoria unificada o compartida |
|---|---|
| Detalle de memoria | 128 GB LPDDR5x memoria del sistema unificada coherente, interfaz 256 bits |
| Tecnología | LPDDR5X |
| Ancho de banda | 273 GB/s |
| Chip o plataforma | GB10 |
| Arquitectura de CPU | ARM64 |
| Software citado por el fabricante | NVIDIA DGX OS (Ubuntu), NeMo, RAPIDS, NIM, NemoClaw, PyTorch |
| Formato | mini-pc |
| Consumo | 240 W |
| Almacenamiento | Hasta 4 TB NVMe M.2 con autocifrado |
| Red | NIC ConnectX-7 200 Gbps (2 puertos QSFP, hasta 200 Gb/s cada uno según cable); 1x RJ-45 10 GbE; Wi-Fi 7; Bluetooth 5.4. 2-3 unidades con cable QSFP directo; 4 unidades requieren switch 200 GbE |
| Estado | a la venta |
Qué falta confirmar
- consumo_w es la potencia del adaptador/fuente indicada en la ficha, no el consumo medido. El TDP del chip GB10 es 140 W según la misma página.
- La página en-us muestra a la vez compra en marketplace y un formulario de aviso de disponibilidad; disponibilidad concreta en España no comprobada.
- La variante de 64 GB no la vende NVIDIA directamente: solo partners OEM (ver entradas OEM).
Antes de comprar, comprueba
- Que tus contenedores y dependencias funcionen en ARM64.
- Proveedor, soporte, configuración y plazo de entrega.
Fuentes
- www.nvidia.com — GB10 y configuración 128 GB; existen otras configuraciones OEM. Consulta: 16 de noviembre de 2026.
- docs.nvidia.com — Arquitectura ARM64 y memoria unificada. Consulta: 16 de noviembre de 2026.
- www.nvidia.com — Memoria 128 GB LPDDR5x 256 bits 273 GB/s, almacenamiento hasta 4 TB, ConnectX-7 200 Gbps, 2x QSFP, 10 GbE, CPU 20 núcleos Arm, fuente 240 W (TDP GB10 140 W), DGX OS y pila de software, compra vía NVIDIA Marketplace y partners. Consulta: 16 de noviembre de 2026.
- marketplace.nvidia.com — NVIDIA Marketplace España: NVIDIA DGX Spark (Founders Edition), 128 GB de memoria unificada, 4 TB NVMe M.2 con autocifrado, a la venta.. Consulta: 17 de noviembre de 2026.