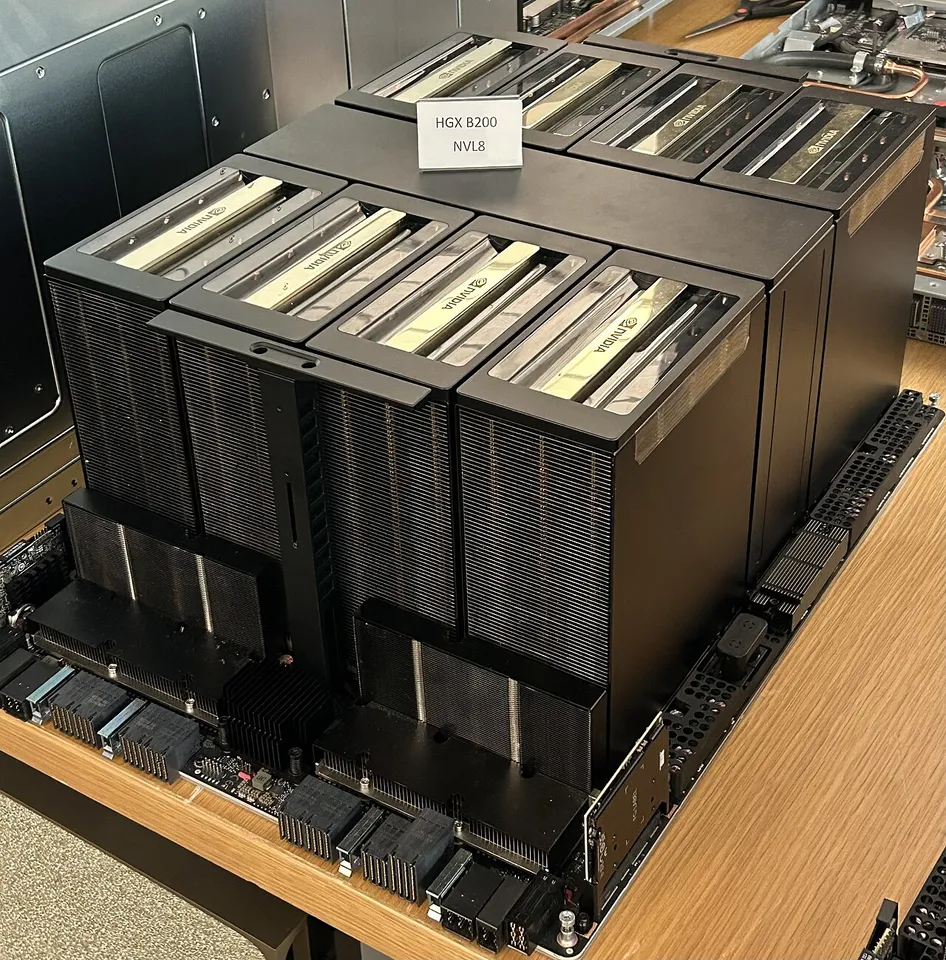
 Foto de referencia
NVIDIA
NVIDIA DGX B200 (8x B200) · 1440 GB
1440 GB vram dedicada · HBM3e · 64.000 GB/s
- 4 bits
- ≈ 1825 B
- 8 bits
- ≈ 1030 B
- 16 bits
- ≈ 545 B
Caben a 4 bits: DeepSeek-V4-Pro, Mistral-Large-4-1T-A52B, Kimi-K2.6.
Comparativa por memoria
Aceleradores de servidor. No se venden como producto de consumo: sirven para dimensionar un proyecto. Comparamos 12 modelos de NVIDIA, AMD por la memoria que publica cada fabricante (vram dedicada) y estimamos qué modelos de IA caben en cada uno.
NVIDIA DGX B200 encabeza la lista con 1440 GB, suficiente para modelos de hasta ≈1825 B parámetros a 4 bits (por ejemplo, DeepSeek-V4-Pro). En el otro extremo, NVIDIA L40S tiene 48 GB, con un tope de ≈61 B.
| Equipo | Memoria | Ancho de banda | 4 bits | 8 bits | 16 bits |
|---|---|---|---|---|---|
| NVIDIA DGX B200 | 1440 GB | 64.000 GB/s | ≈ 1825 B | ≈ 1030 B | ≈ 545 B |
| AMD Instinct MI430X | 432 GB | 23.300 GB/s | ≈ 545 B | ≈ 310 B | ≈ 165 B |
| AMD Instinct MI455X | 432 GB | 23.300 GB/s | ≈ 545 B | ≈ 310 B | ≈ 165 B |
| AMD Instinct MI350X | 288 GB | 8000 GB/s | ≈ 365 B | ≈ 205 B | ≈ 110 B |
| AMD Instinct MI355X | 288 GB | 8000 GB/s | ≈ 365 B | ≈ 205 B | ≈ 110 B |
| AMD Instinct MI450X | 288 GB | 23.300 GB/s | ≈ 365 B | ≈ 205 B | ≈ 110 B |
| AMD Instinct MI325X | 256 GB | 6000 GB/s | ≈ 325 B | ≈ 185 B | ≈ 97 B |
| AMD Instinct MI300X | 192 GB | 5300 GB/s | ≈ 245 B | ≈ 140 B | ≈ 73 B |
| NVIDIA H200 NVL | 141 GB | 4800 GB/s | ≈ 180 B | ≈ 100 B | ≈ 54 B |
| RTX PRO 6000 Blackwell Server | 96 GB | 1597 GB/s | ≈ 120 B | ≈ 69 B | ≈ 36 B |
| NVIDIA H100 NVL | 94 GB | 3900 GB/s | ≈ 120 B | ≈ 67 B | ≈ 36 B |
| NVIDIA L40S | 48 GB | 864 GB/s | ≈ 61 B | ≈ 34 B | ≈ 18 B |
Foto de referenciaNVIDIA
1440 GB vram dedicada · HBM3e · 64.000 GB/s
Caben a 4 bits: DeepSeek-V4-Pro, Mistral-Large-4-1T-A52B, Kimi-K2.6.
AMD · anunciado
432 GB vram dedicada · HBM4 · 23.300 GB/s
Caben a 4 bits: Llama-3.1-405B-Instruct, Llama-4-Maverick-17B-128E-Instruct, Qwen3.5-397B-A17B.
AMD · anunciado
432 GB vram dedicada · HBM4 · 23.300 GB/s
Caben a 4 bits: Llama-3.1-405B-Instruct, Llama-4-Maverick-17B-128E-Instruct, Qwen3.5-397B-A17B.
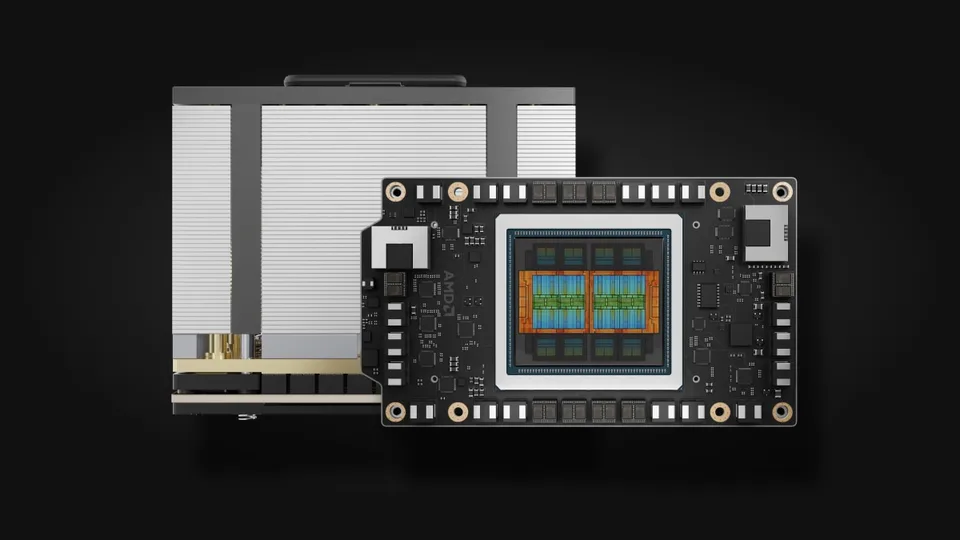
AMD
288 GB vram dedicada · HBM3E (8192-bit) · 8000 GB/s
Caben a 4 bits: GLM-5.3-Flash, DeepSeek-V4-Flash, Llama-3.1-Nemotron-Ultra-253B-v1.
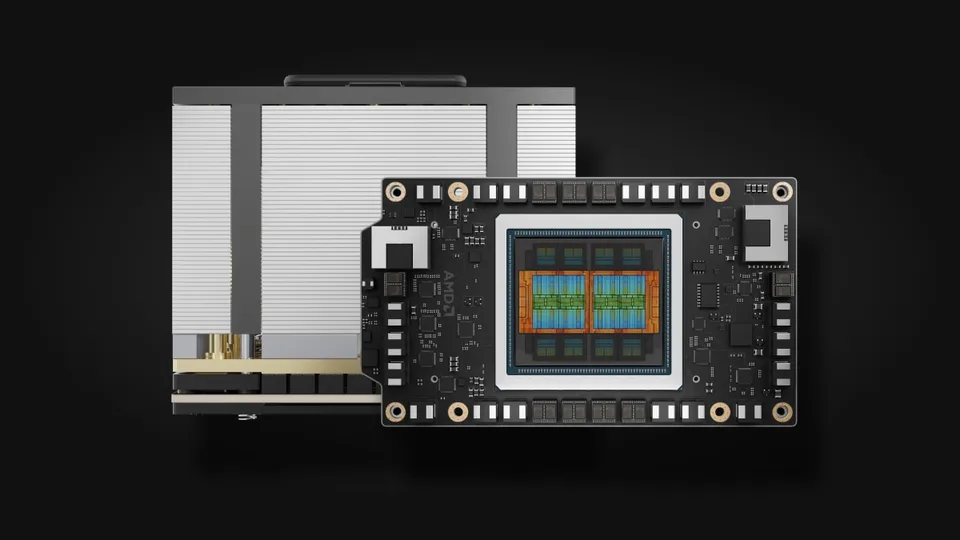 Foto de referencia
AMD
288 GB vram dedicada · HBM3E · 8000 GB/s
Caben a 4 bits: GLM-5.3-Flash, DeepSeek-V4-Flash, Llama-3.1-Nemotron-Ultra-253B-v1.
 Foto de referencia
AMD · anunciado
288 GB vram dedicada · HBM4 · 23.300 GB/s
Caben a 4 bits: GLM-5.3-Flash, DeepSeek-V4-Flash, Llama-3.1-Nemotron-Ultra-253B-v1.
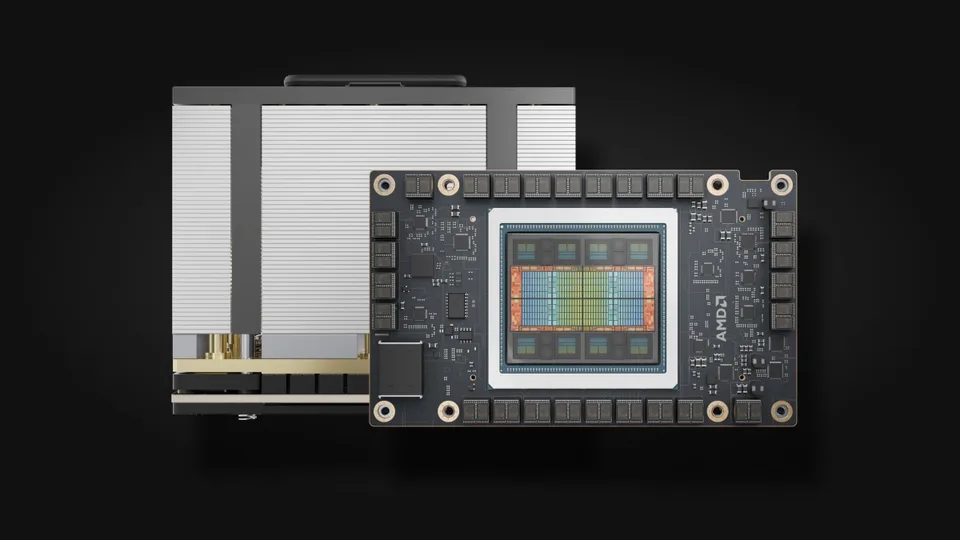
AMD
256 GB vram dedicada · HBM3E (8192-bit) · 6000 GB/s
Caben a 4 bits: GLM-5.3-Flash, DeepSeek-V4-Flash, Llama-3.1-Nemotron-Ultra-253B-v1.
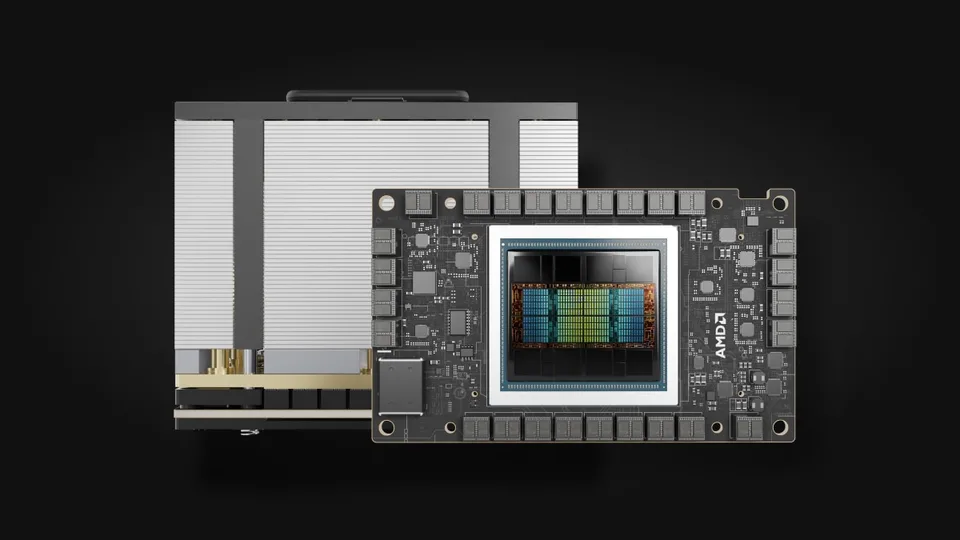
AMD
192 GB vram dedicada · HBM3 (8192-bit) · 5300 GB/s
Caben a 4 bits: Mistral-Medium-3.5-128B, Qwen3.8-Flash-Next, Devstral-2-123B-Instruct-2512.
NVIDIA
141 GB vram dedicada · HBM3e · 4800 GB/s
Caben a 4 bits: Mistral-Medium-3.5-128B, Qwen3.8-Flash-Next, Devstral-2-123B-Instruct-2512.
NVIDIA
96 GB vram dedicada · GDDR7 · 1597 GB/s
Caben a 4 bits: NVIDIA-Nemotron-3-Super-120B-A12B, NVIDIA-Nemotron-3.5-Super-VL-120B-A12B, Mistral-Small-4-119B-2603.
NVIDIA
94 GB vram dedicada · HBM3 · 3900 GB/s
Caben a 4 bits: Mistral-Small-4-119B-2603, gpt-oss-120b, Llama-4-Scout-17B-16E-Instruct.
NVIDIA
48 GB vram dedicada · GDDR6 · 864 GB/s
Caben a 4 bits: Llama-3.3-Nemotron-Super-49B-v1.5, Qwen3.6-35B-A3B, NVIDIA-Nemotron-3.5-Transcribe-30B-A4B.
Tú decides sobre las cookies.
Usamos una cookie necesaria para recordar tu elección. Solo si lo aceptas, medimos las visitas de forma agregada con Google Analytics para saber qué equipos y guías son útiles, y cuántas veces se pulsan los enlaces de tiendas. Ningún dato de las herramientas de la web, como el selector de modelo o las listas de comprobación, se envía. Puedes cambiarlo cuando quieras. Política de cookies.
Imprescindibles para que la web funcione y para recordar tu elección de cookies.
Medición agregada de qué páginas y acciones funcionan, para decidir con datos qué mejorar.