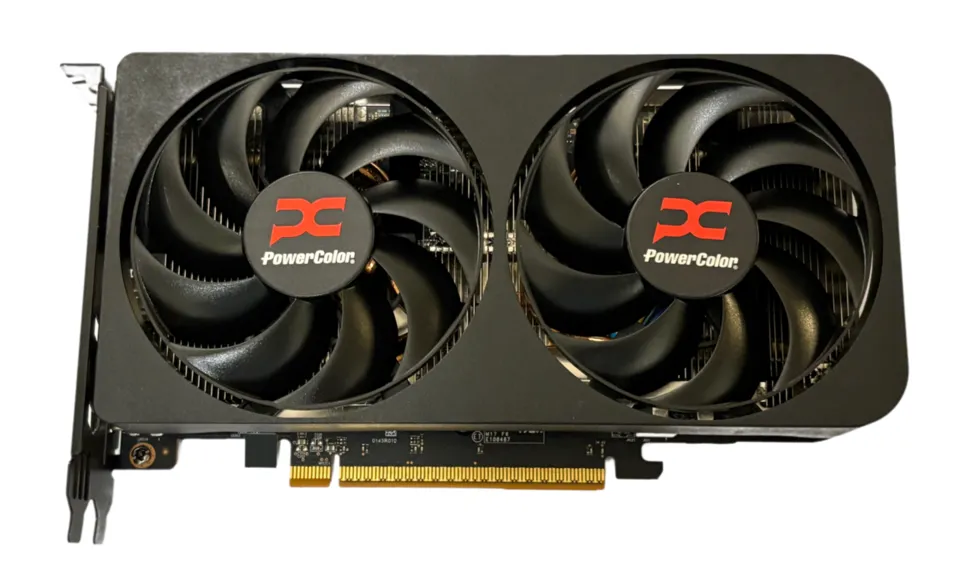

AMD Radeon RX 9060 XT tiene 16 GB de VRAM dedicada (GDDR6 (128-bit, hasta 20 Gbps)), con un ancho de banda de 320 GB/s según el fabricante. Con nuestros supuestos, puede alojar modelos de hasta unos 20 mil millones de parámetros a 4 bits, 11 mil millones a 8 bits y 6,1 mil millones a 16 bits. El mayor modelo de nuestra lista de referencia que cabe con margen a 4 bits es Phi-4-reasoning-vision-15B (15 B); a 16 bits, FLUX.3 Image [klein] (5,6 B). Por memoria utilizable, ocupa el puesto 2 de 15 en tarjetas gráficas de consumo de nuestro catálogo.
Precio y dónde comprar
- 749,95 €en PcComponentes el 17/11/2026.Variante: ASUS Dual Radeon RX 9060 XT 16 GB.Disponibilidad en esa fecha: En stock; entrega mañana según la página.
Precio que mostraba la tienda en la fecha indicada; puede haber cambiado. No es un enlace de afiliado. Compara siempre la misma memoria y el mismo almacenamiento, y comprueba envío e impuestos en la tienda.
Versiones a la venta en Amazon
Varios fabricantes montan esta tarjeta con su propia refrigeración y sus propias medidas. Estas versiones llevan la misma memoria (16 GB); lo comprobamos en su ficha de Amazon el 17 de noviembre de 2026.
| Fabricante | Versión | Vendido por | Enlace |
|---|---|---|---|
| ASUS | Dual RX 9060 XT 16 GB | Amazon | Ver precio (enlace de afiliado, se abre en una pestaña nueva) |
| XFX | Swift RX 9060 XT Dual Fan OC 16 GB | Otro vendedor | Ver precio (enlace de afiliado, se abre en una pestaña nueva) |
| Gigabyte | RX 9060 XT Gaming OC 16G | Amazon | Ver precio (enlace de afiliado, se abre en una pestaña nueva) |
El precio, el vendedor y la disponibilidad los fija Amazon y cambian a menudo. Antes de comprar, comprueba que la tarjeta cabe en tu caja y que tu fuente de alimentación la soporta. Ver todas las versiones en Amazon (enlace de afiliado, se abre en una pestaña nueva).
Como Afiliado de Amazon, obtengo ingresos por las compras adscritas que cumplen los requisitos aplicables. Más información.
Cómo se reparte la memoria
GPU con VRAM dedicada: 95 % de la VRAM (controlador y pantalla consumen el resto). Del espacio utilizable reservamos un 20 % para contexto (caché KV), activaciones y el motor: un usuario con contexto moderado. Contextos largos o varias personas a la vez necesitan más.
Es una tarjeta: el ordenador que la aloja (fuente, refrigeración, placa y memoria del sistema) se dimensiona aparte. Con varias tarjetas la memoria no se suma automáticamente; depende del motor.
Qué modelos caben
Modelos abiertos de referencia, con los parámetros de su ficha oficial. En los modelos MoE caben todos los parámetros aunque solo se activen algunos por palabra generada. Si un modelo se publica ya en 4 bits o menos (lo indicamos junto al nombre), esa es su columna de referencia.
| Modelo | Parámetros | 4 bits | 8 bits | 16 bits |
|---|---|---|---|---|
| FLUX.2 [klein] 4BBlack Forest Labs · pesos oficiales en BF16 | 4 B | Cabe con margen | Cabe con margen | Cabe con margen |
| FLUX.3 Image [klein]Black Forest Labs · pesos oficiales en BF16 | 5,6 B | Cabe con margen | Cabe con margen | Cabe con margen |
| FLUX.2 [klein] 9BBlack Forest Labs · pesos oficiales en BF16 | 9 B | Cabe con margen | Cabe con margen | No cabe |
| FLUX.1 [dev]Black Forest Labs · pesos oficiales en BF16 | 12 B | Cabe con margen | Justo: caben los pesos, poco contexto | No cabe |
| FLUX.2 [dev]Black Forest Labs · pesos oficiales en BF16 | 32 B | No cabe | No cabe | No cabe |
| DeepSeek-V4-FlashDeepSeek · pesos oficiales en FP4+FP8 | 284 B13 B activos | No cabe | No cabe | No cabe |
| DeepSeek-V4.1-FlashDeepSeek · pesos oficiales en FP8 | 552 B16 B activos | No cabe | No cabe | No cabe |
| DeepSeek-V3.2DeepSeek · pesos oficiales en FP8 | 685 B | No cabe | No cabe | No cabe |
| DeepSeek-R1-0528DeepSeek · pesos oficiales en FP8 | 685 B | No cabe | No cabe | No cabe |
| DeepSeek-V4-ProDeepSeek · pesos oficiales en FP4+FP8 | 1600 B49 B activos | No cabe | No cabe | No cabe |
| Gemma 4 E2BGoogle · pesos oficiales en BF16 | 5,1 B2,3 B activos | Cabe con margen | Cabe con margen | Cabe con margen |
| Gemma 4 E4BGoogle · pesos oficiales en BF16 | 8 B4,5 B activos | Cabe con margen | Cabe con margen | No cabe |
| Gemma 4 12BGoogle · pesos oficiales en BF16 | 12 B | Cabe con margen | Justo: caben los pesos, poco contexto | No cabe |
| Gemma 4 26B A4BGoogle · pesos oficiales en BF16 | 25,2 B3,8 B activos | Justo: caben los pesos, poco contexto | No cabe | No cabe |
| Gemma 4 31BGoogle · pesos oficiales en BF16 | 30,7 B | No cabe | No cabe | No cabe |
| granite-4.2-3bIBM · pesos oficiales en BF16 | 3 B | Cabe con margen | Cabe con margen | Cabe con margen |
| granite-4.2-8bIBM · pesos oficiales en BF16 | 8 B | Cabe con margen | Cabe con margen | No cabe |
| granite-4.2-30bIBM · pesos oficiales en BF16 | 30 B | No cabe | No cabe | No cabe |
| Llama-3.1-8B-InstructMeta | 8 B | Cabe con margen | Cabe con margen | No cabe |
| Llama-3.3-70B-InstructMeta | 70 B | No cabe | No cabe | No cabe |
| Llama-4-Scout-17B-16E-InstructMeta · pesos oficiales en BF16 | 109 B17 B activos | No cabe | No cabe | No cabe |
| Llama-4-Maverick-17B-128E-InstructMeta · pesos oficiales en BF16 y FP8 | 400 B17 B activos | No cabe | No cabe | No cabe |
| Llama-3.1-405B-InstructMeta · pesos oficiales en BF16 | 405 B | No cabe | No cabe | No cabe |
| Phi-4-mini-instructMicrosoft · pesos oficiales en BF16 | 3,8 B | Cabe con margen | Cabe con margen | Cabe con margen |
| phi-4Microsoft · pesos oficiales en BF16 | 14 B | Cabe con margen | Justo: caben los pesos, poco contexto | No cabe |
| Phi-4-reasoning-vision-15BMicrosoft · pesos oficiales en BF16 | 15 B | Cabe con margen | No cabe | No cabe |
| Ministral-3-14B-Instruct-2512Mistral AI · pesos oficiales en FP8 | 14 B | Cabe con margen | Justo: caben los pesos, poco contexto | No cabe |
| Devstral-Small-2-24B-Instruct-2512Mistral AI · pesos oficiales en FP8 | 24 B | Justo: caben los pesos, poco contexto | No cabe | No cabe |
| Magistral-Small-2509Mistral AI · pesos oficiales en BF16 | 24 B | Justo: caben los pesos, poco contexto | No cabe | No cabe |
| Mistral-Small-4-119B-2603Mistral AI · pesos oficiales en BF16 y FP8 | 119 B6,5 B activos | No cabe | No cabe | No cabe |
| Devstral-2-123B-Instruct-2512Mistral AI · pesos oficiales en FP8 | 123 B | No cabe | No cabe | No cabe |
| Mistral-Medium-3.5-128BMistral AI · pesos oficiales en BF16 y FP8 | 128 B | No cabe | No cabe | No cabe |
| Mistral-Large-3-675B-Instruct-2512Mistral AI · pesos oficiales en FP8 | 675 B41 B activos | No cabe | No cabe | No cabe |
| Mistral-Large-4-1T-A52BMistral AI · pesos oficiales en FP8 | 1000 B52 B activos | No cabe | No cabe | No cabe |
| Kimi-K2.6Moonshot AI · pesos oficiales en INT4 nativo | 1000 B32 B activos | No cabe | No cabe | No cabe |
| Kimi-K2-Instruct-0905Moonshot AI · pesos oficiales en FP8 (block) | 1000 B32 B activos | No cabe | No cabe | No cabe |
| Kimi-K3Moonshot AI · pesos oficiales en MXFP4 (QAT) | 2800 B104 B activos | No cabe | No cabe | No cabe |
| Kimi-K3.1-ProMoonshot AI · pesos oficiales en MXFP4 (QAT) | 2800 B104 B activos | No cabe | No cabe | No cabe |
| parakeet-tdt-0.6b-v3NVIDIA · pesos oficiales en F32 | 0,6 B | Cabe con margen | Cabe con margen | Cabe con margen |
| canary-1b-v2NVIDIA · pesos oficiales en F32 | 1 B | Cabe con margen | Cabe con margen | Cabe con margen |
| NVIDIA-Nemotron-3-Nano-4BNVIDIA · pesos oficiales en BF16 | 4 B | Cabe con margen | Cabe con margen | Cabe con margen |
| NVIDIA-Nemotron-3.5-Bolt-E4BNVIDIA · pesos oficiales en BF16 | 8 B4 B activos | Cabe con margen | Cabe con margen | No cabe |
| Cosmos-Reason2-8BNVIDIA · pesos oficiales en BF16 | 8,8 B | Cabe con margen | Cabe con margen | No cabe |
| NVIDIA-Nemotron-Nano-9B-v2NVIDIA · pesos oficiales en BF16 | 9 B | Cabe con margen | Cabe con margen | No cabe |
| NVIDIA-Nemotron-Nano-12B-v2-VLNVIDIA · pesos oficiales en BF16 | 12,6 B | Cabe con margen | Justo: caben los pesos, poco contexto | No cabe |
| NVIDIA-Nemotron-3-Nano-30B-A3BNVIDIA · pesos oficiales en BF16 | 30 B3,5 B activos | No cabe | No cabe | No cabe |
| NVIDIA-Nemotron-3.5-Lightning-30B-A3BNVIDIA · pesos oficiales en BF16 | 30 B3 B activos | No cabe | No cabe | No cabe |
| Nemotron-3-Nano-Omni-30B-A3B-ReasoningNVIDIA · pesos oficiales en BF16 | 31 B3 B activos | No cabe | No cabe | No cabe |
| OpenReasoning-Nemotron-32BNVIDIA · pesos oficiales en BF16 | 32 B | No cabe | No cabe | No cabe |
| NVIDIA-Nemotron-3.5-Transcribe-30B-A4BNVIDIA · pesos oficiales en BF16 | 34 B4,3 B activos | No cabe | No cabe | No cabe |
| Llama-3.3-Nemotron-Super-49B-v1.5NVIDIA · pesos oficiales en BF16 | 50 B | No cabe | No cabe | No cabe |
| Cosmos3-SuperNVIDIA · pesos oficiales en BF16 | 64 B | No cabe | No cabe | No cabe |
| NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GBNVIDIA · pesos oficiales en IQ2 (2 bits, QAT) | 74 B9 B activos | No cabe | No cabe | No cabe |
| NVIDIA-Nemotron-3-Super-120B-A12BNVIDIA · pesos oficiales en BF16 | 120 B12 B activos | No cabe | No cabe | No cabe |
| NVIDIA-Nemotron-3.5-Super-VL-120B-A12BNVIDIA · pesos oficiales en BF16 | 120 B12 B activos | No cabe | No cabe | No cabe |
| Llama-3.1-Nemotron-Ultra-253B-v1NVIDIA · pesos oficiales en BF16 | 253 B | No cabe | No cabe | No cabe |
| NVIDIA-Nemotron-3-Ultra-550B-A55BNVIDIA · pesos oficiales en BF16 | 550 B55 B activos | No cabe | No cabe | No cabe |
| whisper-large-v3-turboOpenAI · pesos oficiales en F16 | 0,8 B | Cabe con margen | Cabe con margen | Cabe con margen |
| whisper-large-v3OpenAI · pesos oficiales en F16 | 1,6 B | Cabe con margen | Cabe con margen | Cabe con margen |
| gpt-oss-20bOpenAI · pesos oficiales en MXFP4 | 21 B3,6 B activos | Justo: caben los pesos, poco contexto | No cabe | No cabe |
| gpt-oss-120bOpenAI · pesos oficiales en MXFP4 | 117 B5,1 B activos | No cabe | No cabe | No cabe |
| Qwen3.5-4BQwen (Alibaba) · pesos oficiales en BF16 | 4 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Qwen-Image-2.1Qwen (Alibaba) · pesos oficiales en BF16 | 7 B | Cabe con margen | Cabe con margen | Justo: caben los pesos, poco contexto |
| Qwen3.5-9BQwen (Alibaba) · pesos oficiales en BF16 | 9 B | Cabe con margen | Cabe con margen | No cabe |
| Qwen3.8-27BQwen (Alibaba) · pesos oficiales en BF16 | 27 B | No cabe | No cabe | No cabe |
| Qwen3.6-35B-A3BQwen (Alibaba) · pesos oficiales en BF16 | 35 B3 B activos | No cabe | No cabe | No cabe |
| Qwen3-Coder-NextQwen (Alibaba) · pesos oficiales en BF16 | 80 B3 B activos | No cabe | No cabe | No cabe |
| Qwen3.5-122B-A10BQwen (Alibaba) · pesos oficiales en BF16 | 122 B10 B activos | No cabe | No cabe | No cabe |
| Qwen3.8-Flash-NextQwen (Alibaba) · pesos oficiales en BF16 | 125 B6 B activos | No cabe | No cabe | No cabe |
| Qwen3.5-397B-A17BQwen (Alibaba) · pesos oficiales en BF16 | 397 B17 B activos | No cabe | No cabe | No cabe |
| Qwen3.8-2.4T-A95BQwen (Alibaba) · pesos oficiales en BF16 | 2400 B95 B activos | No cabe | No cabe | No cabe |
| Stable Diffusion 3.5 MediumStability AI · pesos oficiales en BF16 | 2 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Stable Diffusion 3.5 LargeStability AI · pesos oficiales en BF16 | 8 B | Cabe con margen | Cabe con margen | No cabe |
| Wan2.2-TI2V-5BWan-AI (Alibaba) | 5 B | Cabe con margen | Cabe con margen | Cabe con margen |
| Wan2.2-T2V-A14BWan-AI (Alibaba) | 27 B14 B activos | No cabe | No cabe | No cabe |
| GLM-4.7-FlashZhipu AI (Z.ai) · pesos oficiales en BF16 | 30 B3 B activos | No cabe | No cabe | No cabe |
| GLM-4.5-AirZhipu AI (Z.ai) · pesos oficiales en BF16 | 106 B12 B activos | No cabe | No cabe | No cabe |
| GLM-5.3-FlashZhipu AI (Z.ai) · pesos oficiales en FP8 y BF16 | 320 B18 B activos | No cabe | No cabe | No cabe |
| GLM-5.3Zhipu AI (Z.ai) · pesos oficiales en FP8 y BF16 | 753 B | No cabe | No cabe | No cabe |
Equipos con memoria parecida
Otros equipos del catálogo con una memoria utilizable similar (±35 %), de cualquier tipo. Útil para comparar formatos: tarjeta, mini PC, Mac o sistema NVIDIA.
- GeForce RTX 5080 16 GB · vram dedicada · ≈ 20 B a 4 bits
- GeForce RTX 5070 Ti 16 GB · vram dedicada · ≈ 20 B a 4 bits
- GeForce RTX 5060 Ti 16 GB · vram dedicada · ≈ 20 B a 4 bits
- AMD Radeon RX 9070 XT 16 GB · vram dedicada · ≈ 20 B a 4 bits
- AMD Radeon RX 9070 16 GB · vram dedicada · ≈ 20 B a 4 bits
- Intel Arc Pro B50 16 GB · vram dedicada · ≈ 20 B a 4 bits
Ficha técnica
| Memoria | 16 GB · VRAM dedicada |
|---|---|
| Tecnología | GDDR6 (128-bit, hasta 20 Gbps) |
| Ancho de banda | 320 GB/s |
| Software citado por el fabricante | ROCm |
| Formato | tarjeta |
| Consumo | 160 W |
| Estado | desconocido |
Lo que documenta el fabricante
| Consumo de la tarjeta (potencia típica) | 160 W Fuente: amd.com. |
|---|---|
| Fuente de alimentación mínima | 450 W Fuente: amd.com. |
| Conectores de alimentación | 1 conector de 8 pines Fuente: amd.com. |
| Interfaz | PCIe 5.0 x16 Fuente: amd.com. |
Qué falta confirmar
- La matriz ROCm lista «RX 9060 XT» sin distinguir 8 y 16 GB.
- El consumo es la «Typical Board Power (Desktop)» de AMD.
- AMD no indica ranuras ni medidas: dependen del ensamblador.
Antes de comprar, comprueba
- La longitud, el grosor y los conectores del modelo concreto: varían según el ensamblador.
- Que la fuente de alimentación cubra la potencia que recomienda el fabricante y traiga los conectores que pide la tarjeta.
- Que tu software de IA funcione con ella y el coste del equipo completo.
Fuentes
- www.amd.com — Ficha oficial AMD: Versión 16GB: 16 GB GDDR6, 128-bit, hasta 320 GB/s, Typical Board Power 160 W.. Consulta: 16 de noviembre de 2026.
- rocm.docs.amd.com — Matriz de compatibilidad ROCm 10.1.0 (AMD) lista «AMD Radeon RX 9060 XT» como GPU soportada.. Consulta: 16 de noviembre de 2026.
- www.amd.com — Ficha AMD Radeon RX 9060 XT (16 GB): «Typical Board Power (Desktop)» 160 W; «Minimum PSU Recommendation» 450 W; conector adicional 1×8 pines; bus PCIe 5.0 x16. No indica ranuras ni medidas.. Consulta: 17 de noviembre de 2026.
- www.pccomponentes.com — PcComponentes: ASUS Dual Radeon RX 9060 XT 16GB GDDR6, vendida y enviada por PcComponentes, en stock, 749,95 €.. Consulta: 17 de noviembre de 2026.